مدل استدلالی هوش مصنوعی چیست؟ از reasoning effort تا هزینه
مدل استدلالی هوش مصنوعی چیست، توکنهای تفکر چطور شارژ میشوند و reasoning effort را کجا بگذاری؛ با کد Python، خواندن reasoning_tokens و برآورد زندهٔ هزینه.
مدل استدلالی هوش مصنوعی (reasoning model یا thinking model) مدلی زبانی است که پیش از نوشتن پاسخ نهایی، اول «فکر میکند». یعنی یک رشته توکن تولید میکند که در آن مسئله را به قدمهای کوچک میشکند، راهحلها را امتحان میکند و اشتباههای خودش را میگیرد، و بعد بر اساس همین فکر کردن جواب میدهد. این توکنها را معمولاً نمیبینی یا فقط خلاصهشان را میبینی، ولی پولشان را میدهی.
برای برنامهنویس، فهمیدن همین یک جمله مهمترین بخش ماجراست: مدل استدلالی روی مسئلههای چندمرحلهای مثل ریاضی، دیباگ کد، تحلیل یک سند بلند یا برنامهریزی چندقدمی دقیقتر است، ولی کندتر جواب میدهد و چون توکن خروجی بیشتری تولید میکند، گرانتر هم تمام میشود. اینجا میبینی این مدلها چطور کار میکنند، پارامترهای reasoning_effort و reasoning در API یوتاپن چه میکنند، هزینه دقیقاً از کجا بالا میرود و کی اصلاً نباید سراغشان بروی.
مدل استدلالی با مدل معمولی چه فرقی دارد
یک مدل زبانی معمولی، پاسخ را مستقیم و توکن به توکن مینویسد. اگر از آن بخواهی «قدمبهقدم فکر کن»، استدلالش را داخل همان پاسخ مینویسد و تو همهاش را میبینی. مدل استدلالی برای همین کار آموزش دیده که پیش از پاسخ، یک مرحلهٔ جداگانهٔ فکر کردن داشته باشد. خروجی هر درخواست دو بخش دارد:
- توکنهای استدلال (reasoning tokens). متن فکر کردن مدل. بسته به سازندهٔ مدل یا اصلاً برنمیگردد، یا خلاصهاش برمیگردد، یا کاملش در فیلد جداگانه میآید.
- پاسخ نهایی. همان
contentکه همیشه میخواندی.
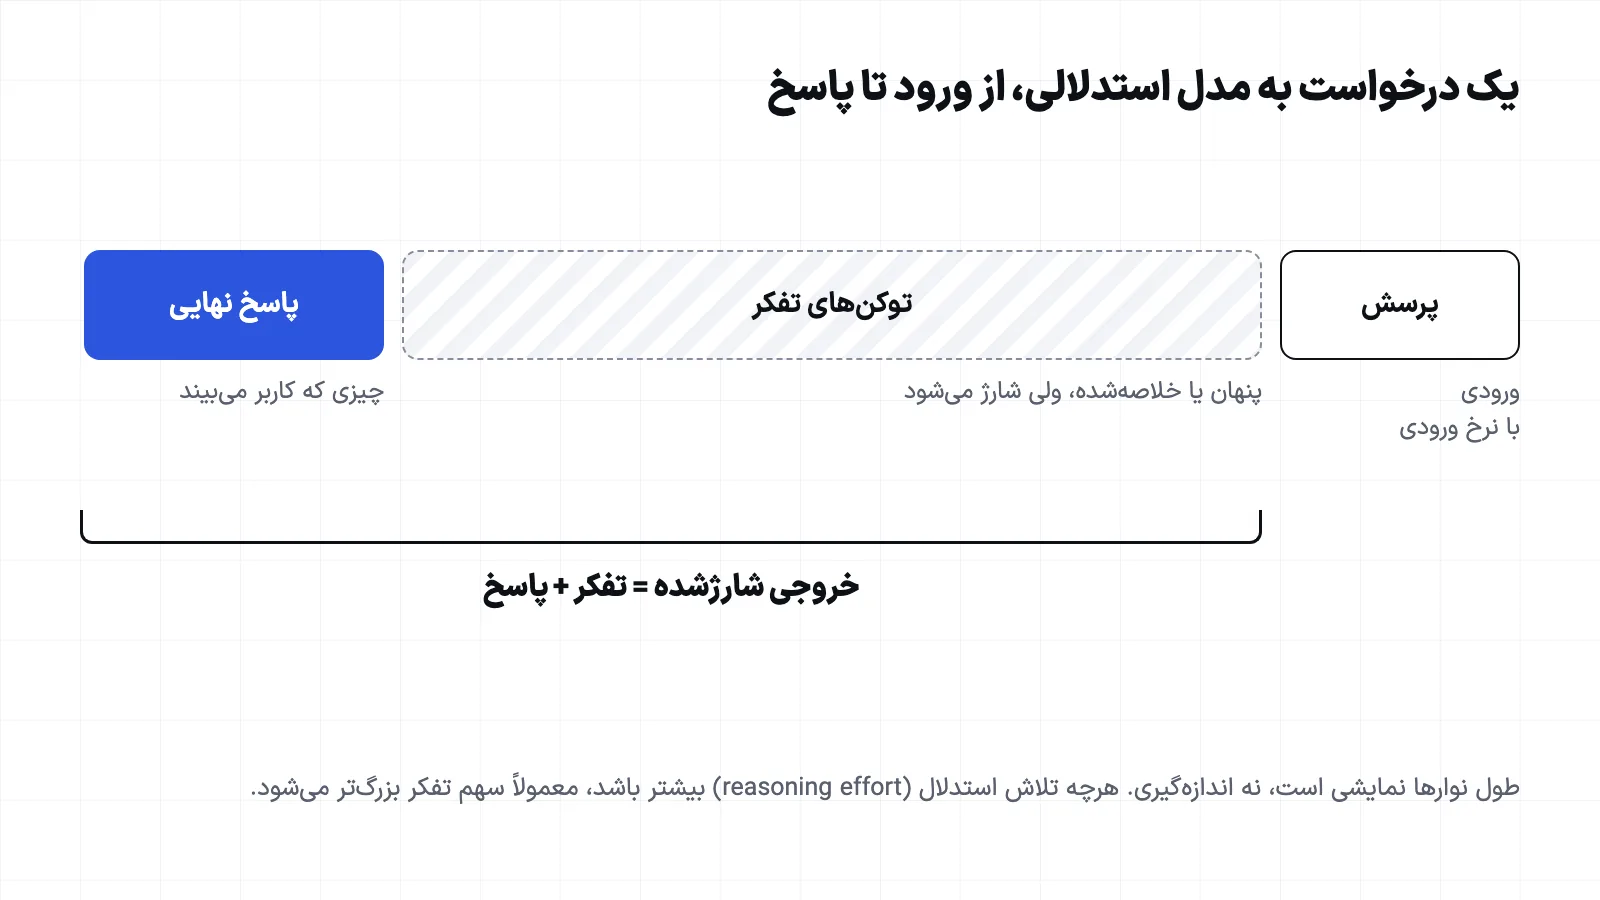
نکتهٔ کلیدی در نسبت این دو است. روی یک سؤال سخت، توکنهای استدلال میتوانند چند برابر خود پاسخ باشند. پاسخی که سه پاراگراف است ممکن است پشتش چند هزار توکن فکر کردن باشد. این عدد ثابت نیست و به سختی مسئله، به مدل و به تنظیم reasoning effort بستگی دارد.
امروز خیلی از مدلهای بزرگ هر دو حالت را دارند و فکر کردن در آنها قابل کم و زیاد کردن یا حتی خاموش کردن است. برای همین «مدل استدلالی» بیشتر یک قابلیت است تا یک دستهبندی سفت. در کاتالوگ یوتاپن، مدلی که در supported_parameters خودش "reasoning" را دارد، این قابلیت را پشتیبانی میکند. فهرست کامل را در دستهٔ مدلهای استدلالی میبینی.
کی از مدل استدلالی استفاده کنی و کی نه
قاعدهٔ ساده: وقتی پاسخ اشتباه از توکن اضافه گرانتر است.
جاهایی که استدلال معمولاً میارزد:
- دیباگ و بازبینی کد. پیدا کردن اینکه چرا یک تابع بازگشتی روی یک ورودی خاص گیر میکند، یا یک race condition از کجا میآید. اگر مدل را برای کدنویسی انتخاب میکنی، مقایسهٔ مدلهای برنامهنویسی روی وظیفههای واقعی را هم ببین.
- ریاضی، منطق و محاسبههای چندمرحلهای. جایی که یک اشتباه در قدم دوم کل جواب را خراب میکند.
- تحلیل سند بلند. مقایسهٔ دو قرارداد، پیدا کردن تناقض در یک مستند فنی، استخراج نتیجه از چند منبع.
- ایجنتها و برنامهریزی. وقتی مدل باید تصمیم بگیرد کدام ابزار را با چه ترتیبی صدا بزند.
جاهایی که استدلال معمولاً پول دور ریختن است:
- کارهای ساده و پرحجم. خلاصهسازی، ترجمه، دستهبندی متن، استخراج فیلد از فاکتور، نوشتن توضیح محصول. مدل غیراستدلالی ارزان اینها را خوب انجام میدهد. گزینههایش را در راهنمای مدلهای ارزان برای پروژههای پرحجم آوردهایم.
- تجربهٔ کاربری که به سرعت حساس است. فکر کردن پیش از اولین توکن پاسخ اتفاق میافتد، پس کاربر بیشتر منتظر میماند. روی سؤالهای سخت این انتظار ممکن است از یک دقیقه هم بگذرد.
- وقتی هنوز پرامپت خوب ننوشتهای. چند مثال و یک دستور روشن روی مدل معمولی خیلی وقتها کار را تمام میکند. اول با مدل معمولی تست کن و فقط اگر کیفیت نرسید، استدلال را روشن کن یا بالا ببر.
چند مدل استدلالی در یوتاپن
«بهترین مدل استدلالی هوش مصنوعی» یک جواب ثابت ندارد و ما هم رتبهبندی یا عدد بنچمارک نمیدهیم، چون نتیجه به نوع مسئلهٔ تو بستگی دارد. این شش مدل شناختهشده همه در کاتالوگ هستند و استدلال را پشتیبانی میکنند. قیمتها زندهاند و بهازای هر یک میلیون توکن.
| مدل | شناسه در API | کنترل میزان استدلال | ورودی (تومان / ۱M توکن) | خروجی (تومان / ۱M توکن) |
|---|---|---|---|---|
| GPT-5 Mini | openai/gpt-5-mini | reasoning_effort | ۸۶٬۵۵۵ | ۶۹۲٬۴۳۹ |
| GPT-5 | openai/gpt-5 | reasoning_effort | ۴۳۲٬۷۷۴ | ۳٬۴۶۲٬۱۹۴ |
| Claude Sonnet 5 | anthropic/claude-sonnet-5 | reasoning_effort | ۶۹۲٬۴۳۹ | ۳٬۴۶۲٬۱۹۴ |
| Gemini 2.5 Pro | google/gemini-2.5-pro | بلوک reasoning | ۴۳۲٬۷۷۴ | ۳٬۴۶۲٬۱۹۴ |
| DeepSeek R1 | deepseek/deepseek-r1 | بلوک reasoning | — | — |
| Kimi K2 Thinking | moonshotai/kimi-k2-thinking | بلوک reasoning | ۲۰۷٬۷۳۲ | ۸۶۵٬۵۴۸ |
چند نکته از توضیح خود سازندهها که در کاتالوگ آمده:
- GPT-5 Mini نسخهٔ جمعوجور GPT-5 برای کارهای استدلالی سبکتر است، با تأخیر و هزینهٔ کمتر. برای شروع، منطقیترین انتخاب این جدول است.
- Claude Sonnet 5 به گفتهٔ Anthropic «adaptive thinking» دارد، یعنی خودش تصمیم میگیرد چقدر فکر کند، و سطحهای مختلف effort را میپذیرد.
- Gemini 2.5 Pro را Google برای استدلال، کد، ریاضی و کارهای علمی معرفی کرده و با پنجرهٔ حدود یک میلیون توکنی، برای استدلال روی ورودی خیلی بلند مناسب است.
- DeepSeek R1 و Kimi K2 Thinking وزنباز (open-weight) هستند. DeepSeek R1 متن کامل استدلالش را برمیگرداند، که برای دیدن مسیر فکر مدل و دیباگ پرامپت به کار میآید.
reasoning effort: پیچ کنترل فکر کردن
دو شکل برای کنترل میزان استدلال پذیرفته میشود و هر دو به سازندهٔ مدل میرسند. جزئیات کامل در مستندات مدلهای استدلالی است.
شکل OpenAI با پارامتر reasoning_effort و مقدارهای low، medium و high. روی مدلهایی که این پارامتر را دارند، مستقیم در SDK کار میکند.
شکل عمومی با بلوک reasoning که از طریق extra_body فرستاده میشود و روی همهٔ مدلهای استدلالی کار میکند:
effort: همانlow/medium/high.max_tokens: سقف مستقیم توکنهای استدلال، برای مدلهایی مثل Anthropic و Gemini که بودجهٔ توکنی میپذیرند. مدلهایی که فقط effort را میفهمند، آن را تقریب میزنند.exclude: true: مدل فکر میکند ولی متن استدلال در پاسخ نمیآید. هزینهٔ فکر کردن کم نمیشود، فقط پاسخ سبکتر است.enabled: false: خاموش کردن استدلال روی مدلهایی که اجازه میدهند.
effort و max_tokens را با هم در یک بلوک نفرست. یکی را انتخاب کن.
برای کار روزمره low یا medium کافی است. high هزینه را چند برابر میکند و فقط برای مسئلههایی میارزد که واقعاً سختاند.
کد Python: فرستادن reasoning_effort و خواندن reasoning tokens
با SDK رسمی OpenAI و فقط با عوض کردن base_url. کلید را از صفحهٔ کلیدهای داشبورد بساز.
import os
from openai import OpenAI
client = OpenAI(
base_url="https://api.uttapen.ir/v1",
api_key=os.environ["UTTAPEN_API_KEY"], # sk-up-...
)
code = open("fib.py", encoding="utf-8").read()
raw = client.chat.completions.with_raw_response.create(
model="openai/gpt-5-mini",
messages=[{
"role": "user",
"content": "این تابع بازگشتی چرا برای n=0 در حلقهٔ بینهایت میافتد؟\n\n" + code,
}],
reasoning_effort="low", # low | medium | high
)
resp = raw.parse()
print(resp.choices[0].message.content)
u = resp.usage
details = u.completion_tokens_details
print("input:", u.prompt_tokens, "output:", u.completion_tokens)
print("reasoning:", details.reasoning_tokens if details else None)
print("cost (toman):", raw.headers.get("x-uttapen-cost-toman"))
usage.completion_tokens_details.reasoning_tokens تعداد توکنهای استدلال را جدا گزارش میکند. بسته به سازندهٔ مدل، این عدد ممکن است داخل completion_tokens شمرده شده باشد یا جدا از آن، پس هزینه را از روی جمع دستی توکنها حساب نکن. مبلغ دقیقی که از کیف پول کم شده در هدر X-Uttapen-Cost-Toman هر پاسخ میآید (در استریم، اگر هدر X-Uttapen-Include-Meta: 1 را بفرستی، در رویداد uttapen.meta). به همین دلیل در کد بالا از with_raw_response استفاده کردهایم تا هدر را هم بخوانیم.
همان درخواست با بلوک عمومی reasoning، برای مدلی مثل DeepSeek R1 که reasoning_effort را در فهرست پارامترهایش ندارد:
resp = client.chat.completions.create(
    model="deepseek/deepseek-r1",
    messages=[{"role": "user", "content": "۱۷ × ۲۳ را مرحله به مرحله حساب کن."}],
    max_tokens=6000,
    extra_body={"reasoning": {"effort": "medium"}},
)

msg = resp.choices[0].message
thinking = (msg.model_extra or {}).get("reasoning")
if thinking:
    print("[استدلال]", thinking[:300])
print(msg.content)
DeepSeek، Gemini و بعضی مدلهای Anthropic متن استدلال را در message.reasoning برمیگردانند. مدلهای OpenAI خلاصه یا هیچ متنی نمیدهند. SDK این فیلد را در کلاسهایش تعریف نکرده، برای همین از model_extra خوانده میشود.
همین را با curl هم میتوانی تست کنی و هدر هزینه را ببینی:
curl -s -D - "https://api.uttapen.ir/v1/chat/completions" \
  -H "Authorization: Bearer $UTTAPEN_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"openai/gpt-5-mini","reasoning_effort":"low",
       "messages":[{"role":"user","content":"عدد اول بعد از ۹۷ چیست؟"}]}' \
  | grep -i -e "x-uttapen-cost-toman" -e "reasoning_tokens"
استریم را جدی بگیر
فکر کردن طولانی ممکن است بیش از یک دقیقه طول بکشد. در حالت غیراستریم، اگر ۱۲۰ ثانیه هیچ بایتی رد و بدل نشود، اتصال قطع میشود. با stream=True متن استدلال (اگر مدل برگرداند) در delta.reasoning و پیش از content میآید و اتصال را زنده نگه میدارد. برای نشان دادن حالت «در حال فکر کردن» در رابط کاربری هم به کار میآید. نمونهٔ کامل استریم در مستندات reasoning هست.
هزینهٔ مدل استدلالی: چرا خروجی باد میکند
توکنهای استدلال با قیمت توکن خروجی همان مدل شارژ میشوند. اگر سازنده برای استدلال قیمت جداگانه گذاشته باشد، همان قیمت حساب میشود و در صفحهٔ مدل هم آمده است. مبنای شارژ نهایی، مصرفی است که خود سازندهٔ مدل برای همان درخواست گزارش میدهد؛ پس هیچ مبلغ تخمینیای از کیف پولت کم نمیشود.
مشکل اینجاست که قیمت خروجی تقریباً همیشه چند برابر قیمت ورودی است، و استدلال دقیقاً همان بخش گران را بزرگ میکند. یک مثال فرضی روی openai/gpt-5-mini: پرسشی با ۱۵۰۰ توکن ورودی (یک تابع و توضیح مشکل) و پاسخی ۴۰۰ توکنی.
اگر مدل فکر نکند، هزار درخواست اینطوری حدود ۴۰۷٬۰۰۰ تومان هزینه دارد.
حالا فرض کن مدل پیش از همان پاسخ ۴۰۰ توکنی، ۲۰۰۰ توکن فکر کند. خروجی شارژشده میشود ۲۴۰۰ توکن و هزار درخواست حدود ۱٬۷۹۰٬۰۰۰ تومان.
پاسخی که کاربر میبیند همان است، ولی هزینه چند برابر شده. عدد ۲۰۰۰ فقط برای مثال است و ثابت نیست. تعداد واقعی را از reasoning_tokens درخواستهای خودت بخوان. برای اینکه حس کنی یک متن فارسی چند توکن میشود، توضیح توکن با اعداد واقعی را ببین.
رزرو موقت و خطای 402
یوتاپن پیش از فرستادن هر درخواست، برآوردی محتاطانه از هزینه را در کیف پولت رزرو میکند و بعد از پاسخ فقط مصرف واقعی را برمیدارد و بقیه را آزاد میکند. وقتی درخواست reasoning یا reasoning_effort دارد، برآورد توکن خروجی برای رزرو سه برابر میشود، چون نمیدانیم مدل چقدر فکر خواهد کرد. اگر با موجودیای که «به نظر» کافی است خطای 402 گرفتی، دلیلش معمولاً همین است. max_tokens را واقعیتر بگذار. توضیح کامل رزرو و تسویه در صفحهٔ قیمتها و مستندات قیمتگذاری است.
تلهٔ max_tokens
روی مدلهای استدلالی، max_tokens هم استدلال را میپوشاند و هم پاسخ را. اگر عدد کوچکی بگذاری، مدل وسط فکر کردن قطع میشود، content خالی برمیگردد و هزینهٔ استدلالی که انجام شده هم پرداخت شده است. برای مسئلههای سخت حداقل ۴۰۰۰ بگذار یا اصلاً ست نکن.
سه قاعده برای خرج کمتر
- پیشفرض را
lowبگذار. فقط مسیرهایی از برنامهات را که واقعاً سختاند رویmediumیاhighببر. - مسیریابی کن. درخواستهای ساده را به مدل غیراستدلالی ارزان بفرست و فقط درخواستهای پیچیده را به مدل استدلالی. کیف پول برای همهٔ مدلها مشترک است و عوض کردن مدل فقط عوض کردن یک رشته است.
- اندازه بگیر.
reasoning_tokensو هدر هزینه را برای چند ده درخواست واقعی لاگ کن. بعد تصمیم بگیر کدام effort و کدام مدل برای کار تو میارزد.
سؤالهای رایج
مدل استدلالی هوش مصنوعی چیست به زبان ساده؟
مدلی که پیش از جواب دادن، یک مرحلهٔ جداگانهٔ فکر کردن دارد: مسئله را قدم به قدم بررسی میکند و بعد پاسخ مینویسد. این فکر کردن به شکل توکن تولید میشود، معمولاً به تو نشان داده نمیشود، ولی با قیمت توکن خروجی شارژ میشود.
reasoning tokens دقیقاً چیست و کجا میبینمش؟
توکنهایی که مدل در مرحلهٔ فکر کردن تولید میکند. تعدادشان در usage.completion_tokens_details.reasoning_tokens پاسخ میآید. اگر مدل متن استدلال را برگرداند (مثل DeepSeek R1)، خود متن را در message.reasoning یا در استریم در delta.reasoning میبینی.
reasoning effort را روی چه بگذارم؟
با low شروع کن. اگر کیفیت پاسخ روی مسئلهٔ تو کافی نبود، medium را امتحان کن. high را برای کارهایی نگه دار که پاسخ اشتباه هزینهٔ واقعی دارد، چون مصرف توکن را چند برابر میکند.
چرا پاسخ مدل استدلالی خالی برگشت ولی پول کم شد؟
تقریباً همیشه به خاطر max_tokens کوچک است. سقف تمام شده در حالی که مدل هنوز در حال فکر کردن بوده، پس content خالی مانده ولی توکنهای استدلال تولید و شارژ شدهاند. سقف را بالاتر ببر یا برندار.
متن استدلال را نمیخواهم؛ هزینه کم میشود؟
نه. exclude: true در بلوک reasoning فقط متن استدلال را از پاسخ حذف میکند و مدل همچنان فکر میکند. برای کم کردن هزینه، effort را پایین بیاور، reasoning.max_tokens را محدود کن، یا روی مدلهایی که اجازه میدهند استدلال را با enabled: false خاموش کن.
بهترین مدل استدلالی هوش مصنوعی کدام است؟
برای همه یک جواب نیست. اگر هزینه و سرعت مهم است، از openai/gpt-5-mini با effort پایین شروع کن. برای کد و تحلیل سنگین، GPT-5 یا Claude Sonnet 5 را کنار هم روی چند نمونهٔ واقعی خودت امتحان کن. اگر ورودی خیلی بلند داری، Gemini 2.5 Pro را هم در مقایسه بگذار. همهٔ اینها با یک کلید و یک کیف پول در دسترساند.
مقالههای مرتبط
- Claude Code در ایران: کلود کد چیست و چطور با Claude کد بزنیکلود کد (Claude Code) چیست، چرا استفاده از آن در ایران سخت است و چطور با opencode یا Cline و کلید یوتاپن از ترمینال و VS Code با مدل Claude کد بزنی.
- خروجی JSON از هوش مصنوعی با structured output و JSON Schemaگرفتن JSON معتبر از مدل زبانی با response_format: فرق json_object و json_schema و tool calling، استخراج فیلد از متن فارسی با Python و مدیریت خطا.
- Seedream چیست؟ راهنمای API سیدریم 4.5 و 5.0 از ایرانSeedream مدل ساخت و ویرایش تصویر ByteDance است. فرق Seedream 4.5 با 5.0 Flash، Lite و Pro، نحوهٔ محاسبهٔ هزینه و کد Python و curl برای API سیدریم.
با شماره موبایل ثبتنام کن، کیف پول را شارژ کن و کلید بگیر. ساخت کلید API ←