خروجی JSON از هوش مصنوعی با structured output و JSON Schema
گرفتن JSON معتبر از مدل زبانی با response_format: فرق json_object و json_schema و tool calling، استخراج فیلد از متن فارسی با Python و مدیریت خطا.
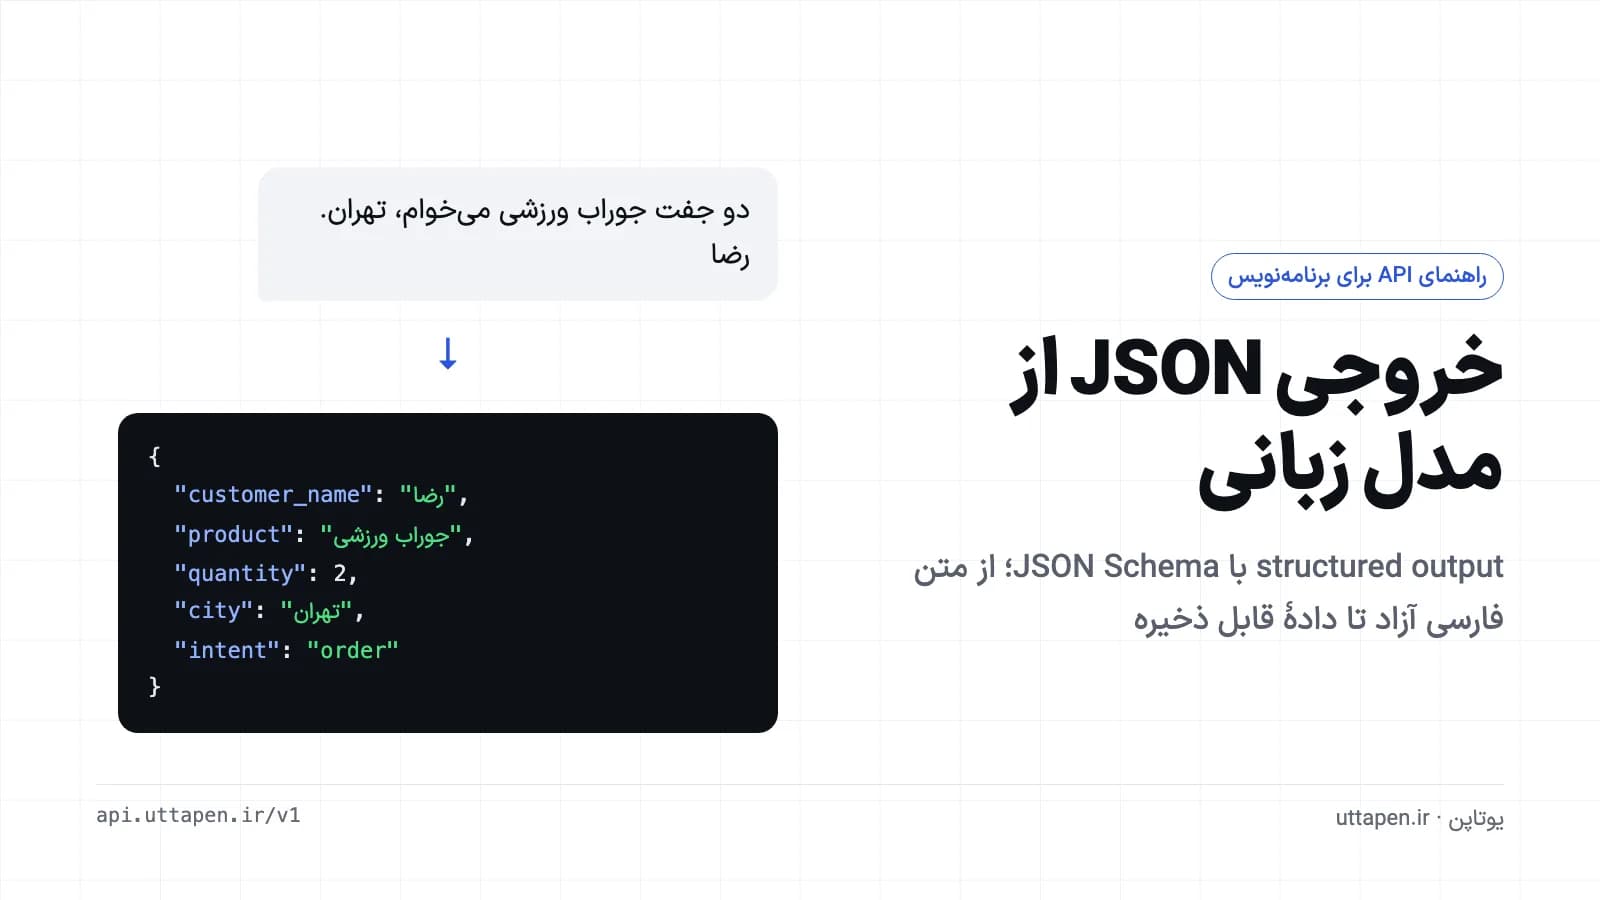
پیام مشتری در دایرکت این است: «سلام، فاطمه احمدی هستم، ۳ تا تیشرت مشکی سایز L میخوام، بفرستید شیراز. ۰۹۱۲۳۴۵۶۷۸۹». تو میخواهی این پیام بدون دخالت آدم به یک ردیف سفارش در دیتابیس تبدیل شود. مدل زبانی این متن را راحت میفهمد. مشکل جای دیگری است: اگر فقط بنویسی «جواب را JSON بده»، یک بار JSON تمیز میگیری، یک بار JSON داخل بلوک ```json، و یک بار جملهای مثل «حتماً! این هم اطلاعات سفارش:» قبل از آن. json.loads در دو حالت آخر خطا میدهد.
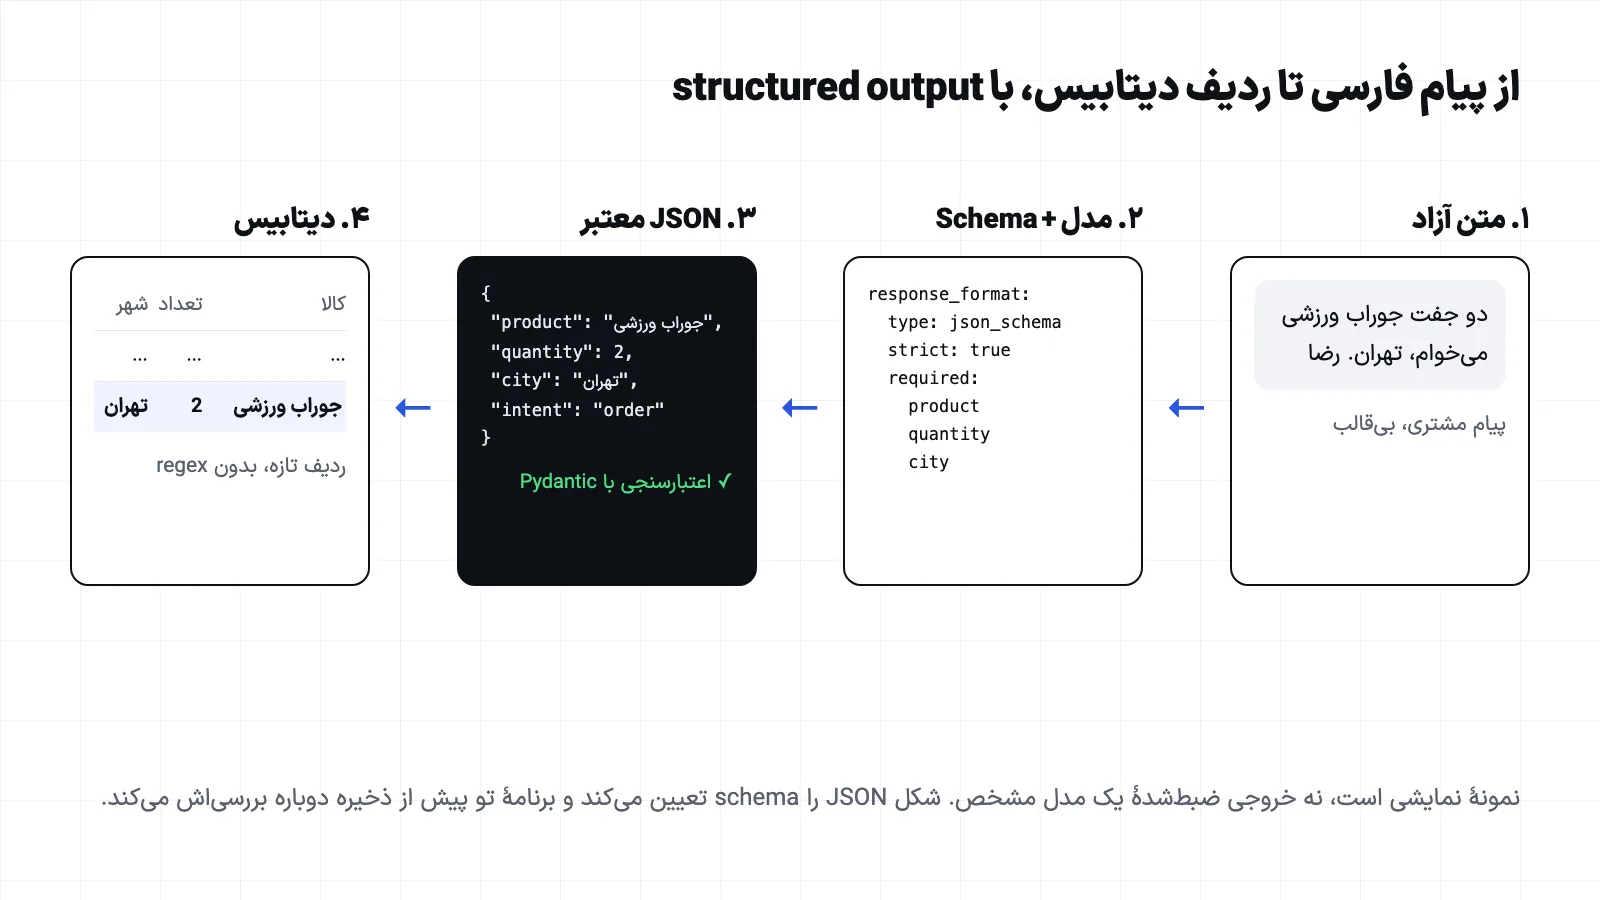
خروجی ساختاریافته (structured output) همین مشکل را حل میکند. با پارامتر response_format به مدل میگویی فقط JSON برگرداند، و در حالت json_schema شکل دقیق آن را هم تعیین میکنی: چه کلیدهایی، با چه نوعی، و کدام مقدارها مجازند. در یوتاپن این پارامتر عیناً به مدل میرسد. پس همان کدی که برای API خود OpenAI نوشتهای، با عوض کردن base_url و کلید کار میکند و با همان کد سراغ مدلهای Google، Anthropic، DeepSeek و Qwen هم میروی.
سه راه برای گرفتن JSON از مدل
سه سازوکار هست و هرکدام جای خودش را دارد:
- json mode (
json_object): مدل تضمین میکند خروجی یک JSON معتبر است، ولی کلیدها و نوعها را فقط از روی توضیح پرامپت حدس میزند. ممکن است کلیدی جا بیفتد یا اسمش کمی فرق کند. - JSON Schema (
json_schemaباstrict: true): اسکیما را میفرستی و مدل هنگام تولید پاسخ مجبور است دقیقاً با آن جور باشد. نه فیلد اضافه میآید، نه فیلدی کم میشود، وenumرعایت میشود. - tool calling: به مدل تابعی با اسکیمای پارامتر معرفی میکنی و مدل آرگومانها را بهصورت JSON برمیگرداند. هدف اصلیاش این است که مدل تصمیم بگیرد کدام کار را انجام دهد، نه اینکه فقط داده استخراج کند.
json_object | json_schema با strict | tool calling | |
|---|---|---|---|
| JSON معتبر | معمولاً؛ بعضی مدلها بلوک کد markdown دورش میگذارند | تضمینی | آرگومانها JSONاند |
| شکل دقیق کلیدها | فقط با توضیح پرامپت | تضمینی | در عمل نزدیک به اسکیما، بسته به مدل |
| کاربرد اصلی | نمونهسازی سریع، مدلهایی که اسکیما را نمیفهمند | استخراج فیلد، دستهبندی، پر کردن فرم | مدل باید بین چند کار انتخاب کند یا دادهای را از سیستم تو بخواند |
| نشان لازم در کاتالوگ | response_format | structured_outputs | tools |
| تعداد درخواست | یک | یک | معمولاً دو یا بیشتر (حلقهٔ اجرا) |
قاعدهٔ ساده: اگر فقط میخواهی متنی را به داده تبدیل کنی، json_schema. اگر مدل باید چیزی را از دیتابیس تو بپرسد یا کاری انجام دهد، tool calling. ساختن یک دستیار فروشگاه که با ابزار به دیتابیس وصل میشود را در مقالهٔ tool calling در عمل قدمبهقدم نوشتهایم و اینجا تکرارش نمیکنیم.
کدام مدلها structured output دارند
در خروجی GET /v1/models، آرایهٔ supported_parameters هر مدل دو نشان مربوط به این بحث دارد: response_format یعنی مدل json mode را میفهمد، و structured_outputs یعنی اسکیمای سختگیرانه را هم اجرا میکند. مدلی که فقط نشان اول را دارد ممکن است درخواست json_schema را با خطای 400 رد کند یا با آن مثل json mode رفتار کند. فهرست زیر از کاتالوگ زندهٔ امروز است و هر شش مدل هر دو نشان را دارند:
| مدل | قیمت ورودی (تومان / ۱M توکن) | قیمت خروجی (تومان / ۱M توکن) |
|---|---|---|
google/gemini-2.5-flash-lite | ۳۴٬۶۲۲ | ۱۳۸٬۴۸۸ |
deepseek/deepseek-v4-flash | ۳۱٬۵۰۶ | ۶۳٬۰۱۲ |
qwen/qwen3-30b-a3b-instruct-2507 | ۳۴٬۶۲۲ | ۱۰۳٬۸۶۶ |
openai/gpt-5-mini | ۸۶٬۵۵۵ | ۶۹۲٬۴۳۹ |
openai/gpt-5.4-mini | ۲۵۹٬۶۶۵ | ۱٬۵۵۷٬۹۸۷ |
anthropic/claude-haiku-4.5 | ۳۴۶٬۲۱۹ | ۱٬۷۳۱٬۰۹۷ |
پیش از استفاده از هر مدل دیگری، نشانهایش را با یک خط چک کن:
curl -s https://api.uttapen.ir/v1/models \
  | jq -r '.data[] | select(.supported_parameters | index("structured_outputs")) | .id' \
  | head -40
مثال کامل: استخراج سفارش از پیام فارسی
مدل مثال google/gemini-2.5-flash-lite است: ارزان است و structured_outputs دارد. اگر مدل استدلالی انتخاب کردی، max_tokens را بزرگتر بگذار، چون توکنهای استدلال هم از همین سقف کم میشوند. اگر SDK را تازه به یوتاپن وصل میکنی، راهنمای عوض کردن base_url در SDK OpenAI را ببین. کلید را از صفحهٔ کلیدهای داشبورد میسازی.
import json
import os
from openai import OpenAI
client = OpenAI(
base_url="https://api.uttapen.ir/v1",
api_key=os.environ["UTTAPEN_API_KEY"], # sk-up-...
)
MODEL = "google/gemini-2.5-flash-lite"
ORDER_SCHEMA = {
"type": "object",
"properties": {
"customer_name": {"type": ["string", "null"]},
"phone": {
"type": ["string", "null"],
"description": "شمارهٔ موبایل با ارقام لاتین، بدون فاصله، مثل 09123456789",
},
"product": {"type": "string", "description": "نام کالا همانطور که مشتری گفته"},
"quantity": {"type": "integer", "description": "تعداد؛ اگر نگفته 1"},
"city": {"type": ["string", "null"]},
"intent": {"type": "string", "enum": ["order", "question", "complaint"]},
},
"required": ["customer_name", "phone", "product", "quantity", "city", "intent"],
"additionalProperties": False,
}
SYSTEM = (
"از پیام مشتری فروشگاه اطلاعات سفارش را استخراج کن و فقط JSON برگردان. "
"چیزی که در پیام نیامده را حدس نزن و null بگذار."
)
def extract_order(text: str):
resp = client.chat.completions.create(
model=MODEL,
messages=[
{"role": "system", "content": SYSTEM},
{"role": "user", "content": text},
],
response_format={
"type": "json_schema",
"json_schema": {"name": "order", "strict": True, "schema": ORDER_SCHEMA},
},
max_tokens=400,
temperature=0,
)
return resp
resp = extract_order(
"سلام، فاطمه احمدی هستم. ۳ تا تیشرت مشکی سایز L میخوام، بفرستید شیراز. ۰۹۱۲۳۴۵۶۷۸۹"
)
order = json.loads(resp.choices[0].message.content)
print(json.dumps(order, ensure_ascii=False, indent=2))
print(resp.usage.prompt_tokens, resp.usage.completion_tokens)
چند نکته در همین کد:
- در حالت strict همهٔ فیلدها در
requiredمیآیند وadditionalProperties: Falseالزامی است. فیلدی را که ممکن است در پیام نباشد اختیاری نکن. نوعش را["string", "null"]بگذار تا مدل بتواندnullبرگرداند و چیزی از خودش نسازد. enumبهترین ابزار دستهبندی است. برای دستهبندی تیکت پشتیبانی یا نوع پیام، مقدارهای مجاز را باenumببند. اینطوری کد تو هیچوقت با «شکایت» بهجایcomplaintروبهرو نمیشود.descriptionهر فیلد بخشی از دستور به مدل است. قاعدهٔ قالب (مثل «ارقام لاتین») را همانجا بنویس.ensure_ascii=Falseفقط برای چاپ و لاگ است. بدون آنjson.dumpsفارسی را به شکل\u0641\u0627...مینویسد. این JSON معتبر است وjson.loadsدرستش میکند، فقط خواندنش سخت است.
همین درخواست با curl:
curl -s https://api.uttapen.ir/v1/chat/completions \
-H "Authorization: Bearer $UTTAPEN_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "google/gemini-2.5-flash-lite",
"max_tokens": 200,
"messages": [{"role": "user", "content": "تیکت: سفارش ۴۵۱۲ هنوز نرسیده. این پیام را دستهبندی کن."}],
"response_format": {"type": "json_schema", "json_schema": {"name": "ticket", "strict": true,
"schema": {"type": "object", "additionalProperties": false, "required": ["category", "order_id"],
"properties": {"category": {"type": "string", "enum": ["delivery", "payment", "product", "other"]},
"order_id": {"type": ["string", "null"]}}}}}
}' | jq -r '.choices[0].message.content'
Pydantic بهجای اسکیمای دستی
نوشتن اسکیما بهصورت dict زود طولانی میشود. SDK Python متد client.chat.completions.parse را دارد که اسکیما را از یک کلاس Pydantic میسازد و خروجی را مستقیم به نمونهٔ همان کلاس تبدیل میکند. این متد از یوتاپن هم کار میکند (مستندات خروجی ساختیافته):
from typing import Literal, Optional
from pydantic import BaseModel, Field
class Order(BaseModel):
customer_name: Optional[str]
phone: Optional[str] = Field(description="ارقام لاتین، بدون فاصله")
product: str
quantity: int
city: Optional[str]
intent: Literal["order", "question", "complaint"]
resp = client.chat.completions.parse(
model=MODEL,
messages=[
{"role": "system", "content": SYSTEM},
{"role": "user", "content": "دو جفت جوراب ورزشی میخوام، تهران. رضا"},
],
response_format=Order,
max_tokens=400,
)
msg = resp.choices[0].message
if msg.parsed:
print(msg.parsed.quantity, msg.parsed.city)
else:
print("پاسخ قابل استفاده نیست:", msg.refusal)
در Node هم همین کار با Zod و zodResponseFormat انجام میشود و نمونهاش در مستندات آمده.
وقتی JSON خراب یا ناقص برمیگردد
حتی با json_schema هم کد تولیدی باید این چهار حالت را بشناسد:
- بریده شدن پاسخ (
finish_reason == "length"). اگرmax_tokensکم باشد، JSON وسط کار قطع میشود و قابل parse نیست، ولی هزینهٔ توکنهایش را دادهای.max_tokensرا برای بزرگترین خروجی ممکن تنظیم کن. روی مدلهای استدلالی این سقف شامل توکنهای استدلال هم هست، پس عدد خیلی کوچک پاسخ را خالی برمیگرداند (جزئیات در مستندات استدلال). متدparseدر این حالت خطایopenai.LengthFinishReasonErrorمیدهد. - امتناع مدل (refusal). بعضی مدلها بهجای JSON یک متن امتناع در
message.refusalمیگذارند وcontentخالی است. قبل ازjson.loadsاین فیلد را چک کن. - مدلی که اسکیما را کامل اجرا نمیکند. اگر مدل
structured_outputsندارد یا با json mode کار میکنی، خروجی ممکن است کلیدی کم داشته باشد. همیشه خروجی را اعتبارسنجی کن. - خطای شبکه،
5xxیا429. اینها را با رعایت هدرRetry-Afterمیتوانی دوباره بفرستی (بهجز429سقف ماهانهٔ کلید). خطاهای400را تکرار نکن، چون نتیجه عوض نمیشود. فهرست کامل کدها در صفحهٔ خطاها است.
یک الگوی ساده با اعتبارسنجی Pydantic و حداکثر دو بار تلاش:
from pydantic import ValidationError

def extract_with_retry(text: str, attempts: int = 2) -> Order | None:
    for _ in range(attempts):
        resp = extract_order(text)
        choice = resp.choices[0]
        if choice.finish_reason == "length" or getattr(choice.message, "refusal", None):
            return None  # بیشتر کردن max_tokens یا بررسی دستی؛ تکرار کورکورانه فقط هزینه است
        try:
            return Order.model_validate_json(choice.message.content)
        except ValidationError:
            continue  # یک بار دیگر؛ اگر باز خراب بود، مسیر دستی
    return None
اگر None برگشت، پیام را برای بررسی دستی کنار بگذار. سفارش مشتری نباید بهخاطر یک پاسخ خراب مدل گم شود.
اسکیمای خوب چه شکلی است
بیشتر خطاهای استخراج از خود اسکیما میآیند، نه از مدل. چند قاعده که در عمل جواب میدهد:
- اسکیما را تخت نگه دار. سه یا چهار سطح object تودرتو هم کار میکند، ولی هر سطح اضافه یعنی جای بیشتر برای اشتباه و توکن بیشتر. اگر یک پیام چند کالا دارد، یک آرایهٔ
itemsبا objectهای ساده کافی است. - برای هر فیلد یک معنا. فیلدی مثل
addressکه گاهی شهر است و گاهی آدرس کامل، در دیتابیس دردسر میسازد.cityوaddress_lineرا جدا کن. - راه فرار بگذار. اگر پیام اصلاً سفارش نیست، مدل باید بتواند این را بگوید. مقدار
questionیاotherدرenumو نوع nullable برای فیلدها جلوی ساختن داده از هیچ را میگیرد. - ترتیب فیلدها مهم است. مدلها معمولاً فیلدها را به ترتیب اسکیما تولید میکنند. اگر فیلدی مثل
intentبه فهم کل پیام نیاز دارد و فیلدهای بعدی به آن وابستهاند، آن را اول بگذار. - نسخه بزن. اسکیما بخشی از قرارداد کد توست. وقتی فیلدی اضافه یا حذف میکنی، نام آن را در
json_schema.nameعوض کن (مثلorder_v2) و در لاگ نگه دار کدام نسخه کدام ردیف را ساخته.
چند کاربرد رایج
همین الگو، با عوض کردن اسکیما، برای کارهای زیادی کار میکند:
- دستهبندی تیکت پشتیبانی. فیلد
categoryباenum، فیلدurgencyبا سه مقدار، وorder_idnullable. خروجی مستقیم به صف درست میرود. - مرتب کردن لیست کالای تأمینکننده. متن آشفتهٔ «پیراهن مردانه نخی سایز M تا XXL رنگ سفید و آبی» به آرایهای از
name،sizesوcolorsتبدیل میشود که مستقیم در فرم محصول فروشگاه مینشیند. - خواندن فاکتور و رسید. اگر ورودی تصویر است، مدلی را انتخاب کن که هم ورودی تصویر و هم
structured_outputsدارد. خواندن فاکتور فارسی با vision را در مقالهٔ پردازش تصویر و فاکتور فارسی کامل نوشتهایم. - تحلیل نظرهای کاربران. برای هر نظر
sentimentو فهرست موضوعها را بگیر و بعد در SQL آمار بساز. اینجا مدل ارزان کاملاً کافی است، چون کار ساده و حجم بالاست.
برای حجم بالا، درخواستها را همزمان ولی محدود بفرست (مثلاً با asyncio.Semaphore) و سقف نرخ کلیدت را رعایت کن. هر پیام را جدا بفرست، نه ده پیام در یک درخواست. اینطوری اگر یکی خراب شد، فقط همان را دوباره میفرستی.
دامهای متن فارسی
- ارقام فارسی و عربی. با وجود
description، مدل گاهی"۰۹۱۲..."برمیگرداند. یک نرمالساز بعد از parse بگذار:
DIGITS = str.maketrans("۰۱۲۳۴۵۶۷۸۹٠١٢٣٤٥٦٧٨٩", "01234567890123456789")

def normalize_fa(s: str | None) -> str | None:
    if s is None:
        return None
    return s.translate(DIGITS).replace("ي", "ی").replace("ك", "ک").strip()

order["phone"] = normalize_fa(order["phone"])
- مبلغ و جداکنندهٔ هزارگان. مبلغی مثل «۱٬۲۵۰٬۰۰۰» در پیام مشتری ممکن است بهصورت رشته برگردد. در اسکیما نوع را
integerبگذار و درdescriptionبنویس «بدون جداکننده». اگر مشتری «یک و نیم میلیون» نوشته، مقایسه با مبلغ واقعی سفارش را به کد خودت بسپار. - ی و ک عربی و نیمفاصله. اگر مقدار استخراجشده را با دیتابیس مقایسه میکنی (نام شهر، نام کالا)، هر دو طرف را یکسان کن. برای مقدارهای محدود از
enumاستفاده کن. - توکن بیشتر برای فارسی. متن فارسی معمولاً توکن بیشتری از متن انگلیسی همطول مصرف میکند. عدد واقعی را در مقالهٔ توکن چیست اندازه گرفتهایم. نام فیلدها را انگلیسی و کوتاه نگه دار تا خروجی کوچک بماند.
هزینهٔ استخراج JSON
هزینه مثل هر درخواست دیگر بر اساس توکن ورودی و خروجی است و از کیف پول تومانی کم میشود. خروجی JSON معمولاً کوتاهتر از جواب متنی است. برای مثال، اگر هر پیام سفارش با پرامپت سیستمی حدود ۴۰۰ توکن ورودی و ۱۲۰ توکن خروجی داشته باشد، استخراج ۱۰۰۰ پیام با google/gemini-2.5-flash-lite حدود ۳۰٬۵۰۰ تومان هزینه دارد. این عدد را با usage.prompt_tokens و usage.completion_tokens چند پیام واقعی خودت دقیق کن. قیمت بقیهٔ مدلها در جدول بالا و توضیح کلی در صفحهٔ قیمتها است.
سؤالهای رایج
فرق json mode و structured output چیست؟
json mode ("type": "json_object") فقط تضمین میکند خروجی JSON معتبر است. structured output ("type": "json_schema" با strict: true) علاوه بر آن تضمین میکند خروجی دقیقاً با اسکیمای تو جور است: همان کلیدها، همان نوعها و همان مقدارهای enum. برای کدی که خروجی را مستقیم در دیتابیس مینویسد، json_schema را انتخاب کن.
چرا با json_object خطای 400 میگیرم؟
در حالت json_object کلمهٔ «JSON» باید جایی در پیامها آمده باشد، وگرنه بعضی سازندههای مدل درخواست را رد میکنند. یک جمله مثل «فقط JSON برگردان» در پیام سیستمی کافی است. اگر با json_schema خطای 400 میگیری، احتمالاً مدل نشان structured_outputs را ندارد یا اسکیمای strict ناقص است (فیلدی بیرون از required مانده یا additionalProperties: false جا افتاده).
آیا client.chat.completions.parse از یوتاپن کار میکند؟
بله. یوتاپن response_format را عیناً عبور میدهد، پس parse با کلاس Pydantic در Python و zodResponseFormat در Node همان رفتاری را دارند که با API خود OpenAI دارند. فقط مدلی انتخاب کن که structured_outputs داشته باشد.
structured output بهتر است یا function calling؟
برای تبدیل متن به داده، structured output سادهتر است: یک درخواست، یک JSON. function calling وقتی لازم است که مدل باید بین چند کار انتخاب کند یا اطلاعاتی را از سیستم تو بخواند. برای مدلی که structured_outputs ندارد ولی tools دارد، یک ابزار با tool_choice اجباری جایگزین خوبی است (مستندات tool calling).
JSON Schema در API چه محدودیتهایی دارد؟
در حالت strict همهٔ فیلدها باید در required باشند و additionalProperties: false در هر object الزامی است. فیلد اختیاری را با نوع nullable مثل ["string", "null"] بساز. پشتیبانی از کلیدواژههای پیشرفتهٔ JSON Schema بین مدلها یکسان نیست. اسکیما را ساده نگه دار و قیدهای پیچیده را بعد از parse در کد خودت بررسی کن.
خروجی JSON مدل فارسی را به شکل \u0641 نشان میدهد. خراب است؟
نه. این Unicode escape کاملاً معتبر است و json.loads آن را به همان متن فارسی برمیگرداند. اگر موقع چاپ یا لاگ اینطور میبینی، در json.dumps گزینهٔ ensure_ascii=False را بگذار.
مقالههای مرتبط
- چطور کد OpenAI خودت را با تغییر یک خط به یوتاپن وصل کنی (Python، Node، PHP)راهنمای عملی تغییر base_url در SDK رسمی OpenAI برای Python، Node.js و PHP، با کد تستشده، خواندن هزینهٔ تومانی از هدر پاسخ و نکات مهاجرت بدون شکستن کد.
- بهترین مدل هوش مصنوعی برای برنامهنویسی در ۱۴۰۵ — تست روی ۵ وظیفهٔ واقعیبهجای جدول امتیاز آماده، یک harness باز میگیری: ۵ وظیفهٔ واقعی، تست خودکار، هزینهٔ تومانی هر مدل. خودت اجرا کن و نتیجهٔ کدِ خودت را ببین.
- پردازش تصویر با مدلهای vision: خواندن فاکتور و فرم فارسی با خروجی JSONارسال تصویر با data URI، گرفتن فیلدهای فاکتور فارسی بهصورت JSON با json_schema، و نکتههای عملی برای بالا بردن دقت OCR فارسی — با کد پایتون تستشده.
با شماره موبایل ثبتنام کن، کیف پول را شارژ کن و کلید بگیر. ساخت کلید API ←